GroovyMorning_RLAC
Introduction à GroovyMorning : Personnalisation du flux radio en temps réel
Cette série d’articles documente les défis techniques et les solutions architecturales mis en oeuvre pour assurer la capture, l’analyse et la distribution automatisée des chroniques radio.
Les piliers du système
Pour passer d’un signal audio brut à une application mobile fonctionnelle, GroovyMorning repose sur les cinq piliers suivants :
- La Capture (RLAC-AudioRecorder) : Un module Java haute disponibilité assurant l’enregistrement continu et la segmentation HLS.
- L’Intelligence (IAChronicleDetector) : Un moteur d’analyse Python exploitant de l’intelligence artificielle pour identifier les différentes chroniques en live.
- La Synchronisation : Un mécanisme de correction temporelle et de fingerprinting pour aligner les flux distribués.
- L’Infrastructure de Données : Un pipeline de création de datasets pour l’entraînement et l’évaluation des modèles.
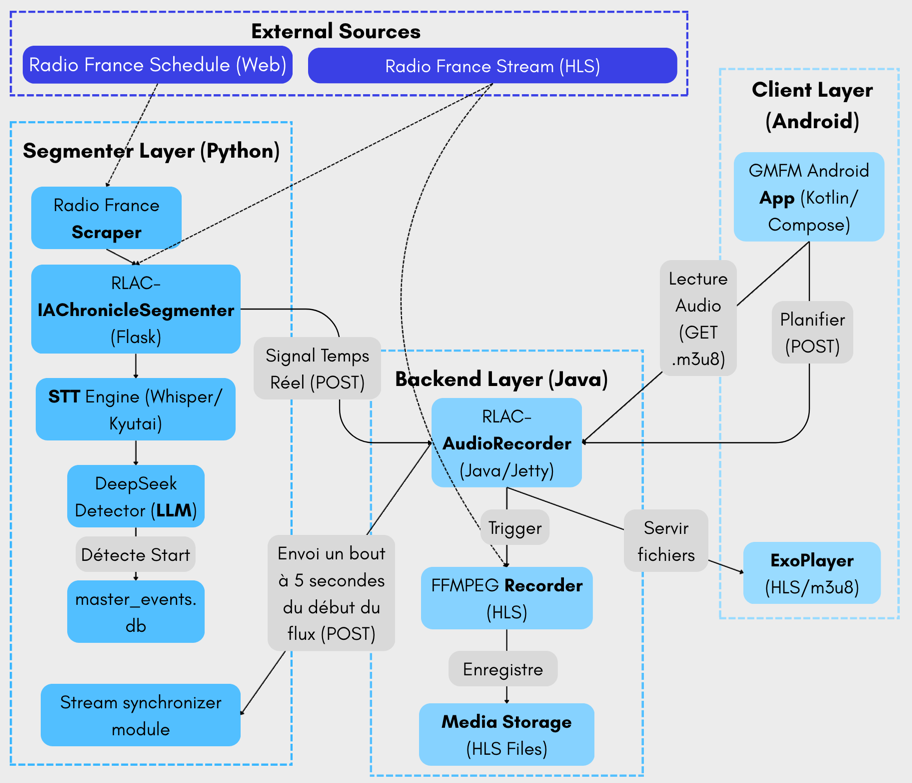
- L’application mobile : Une application mobile permettant aux utilisateurs de customiser la grille de la radio et d’écouter cette dernière.
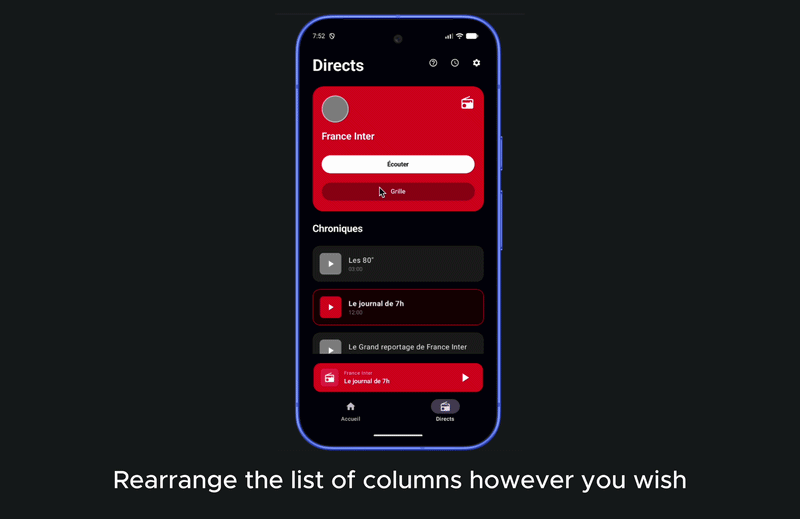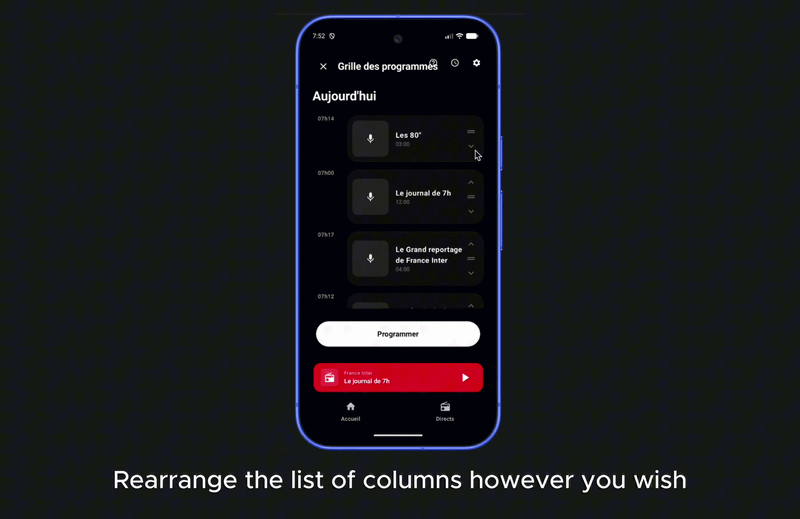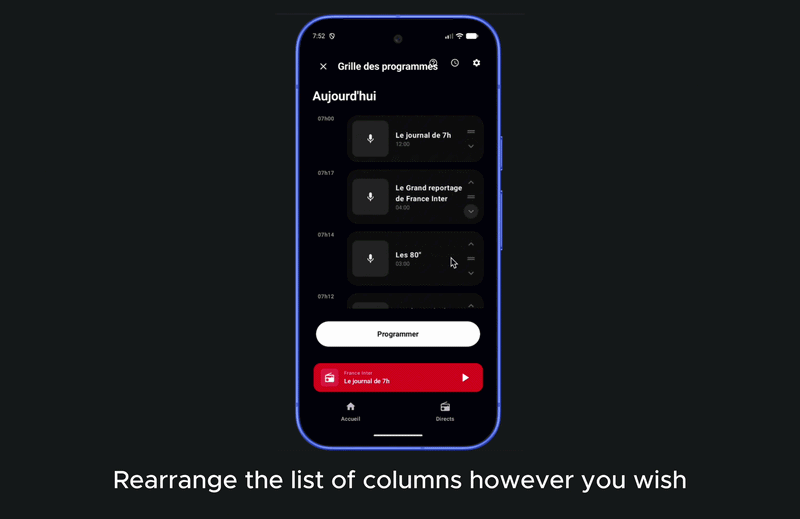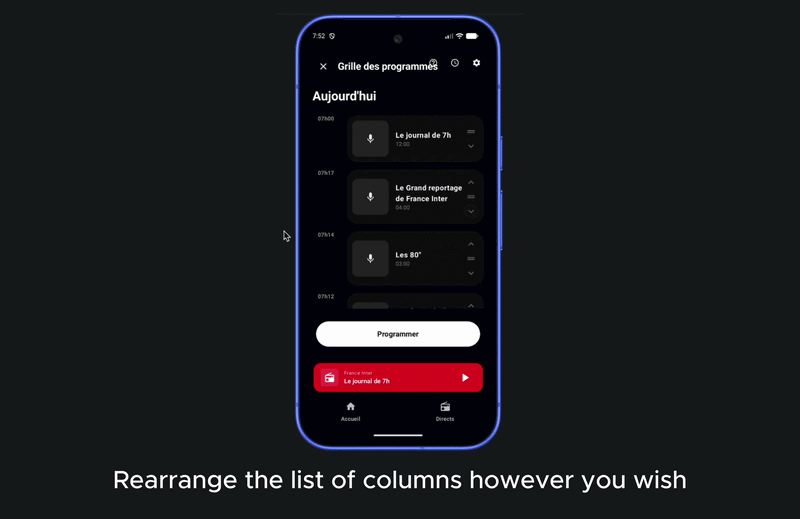
Structure de la série technique
La série est structurée en douze chapitres abordant chacun une facette spécifique du pipeline de traitement.
1. Détection de chroniques par IA
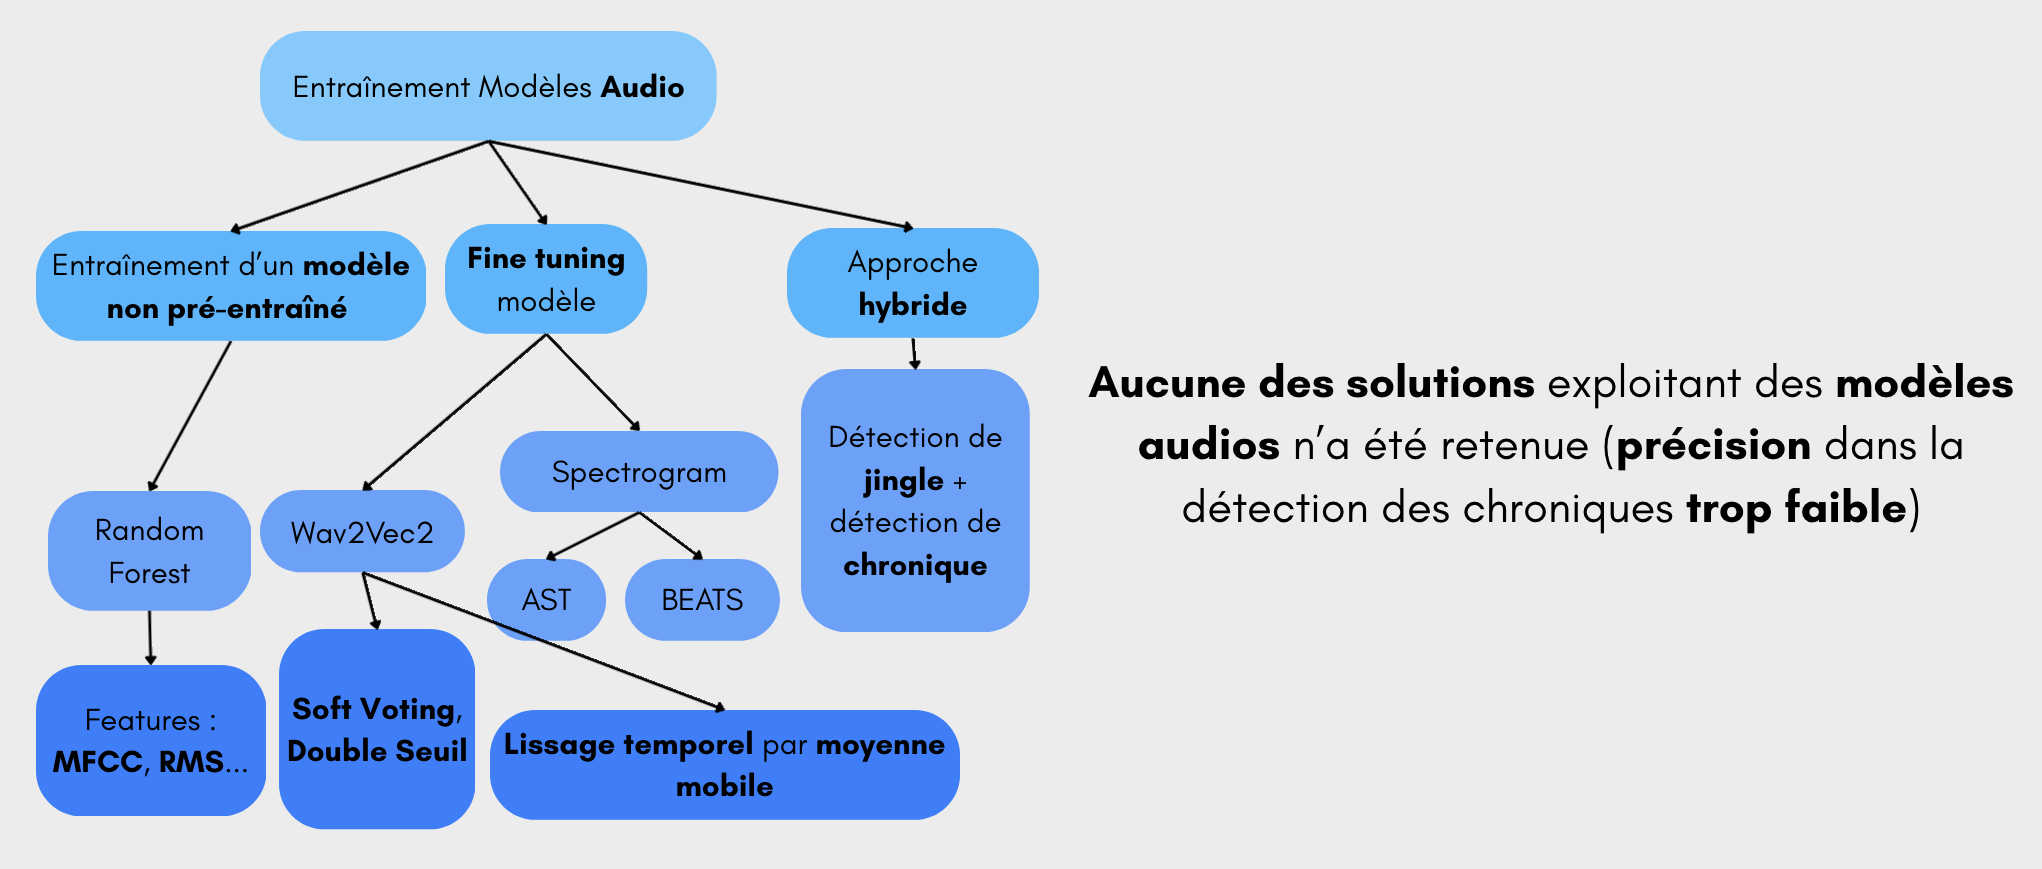
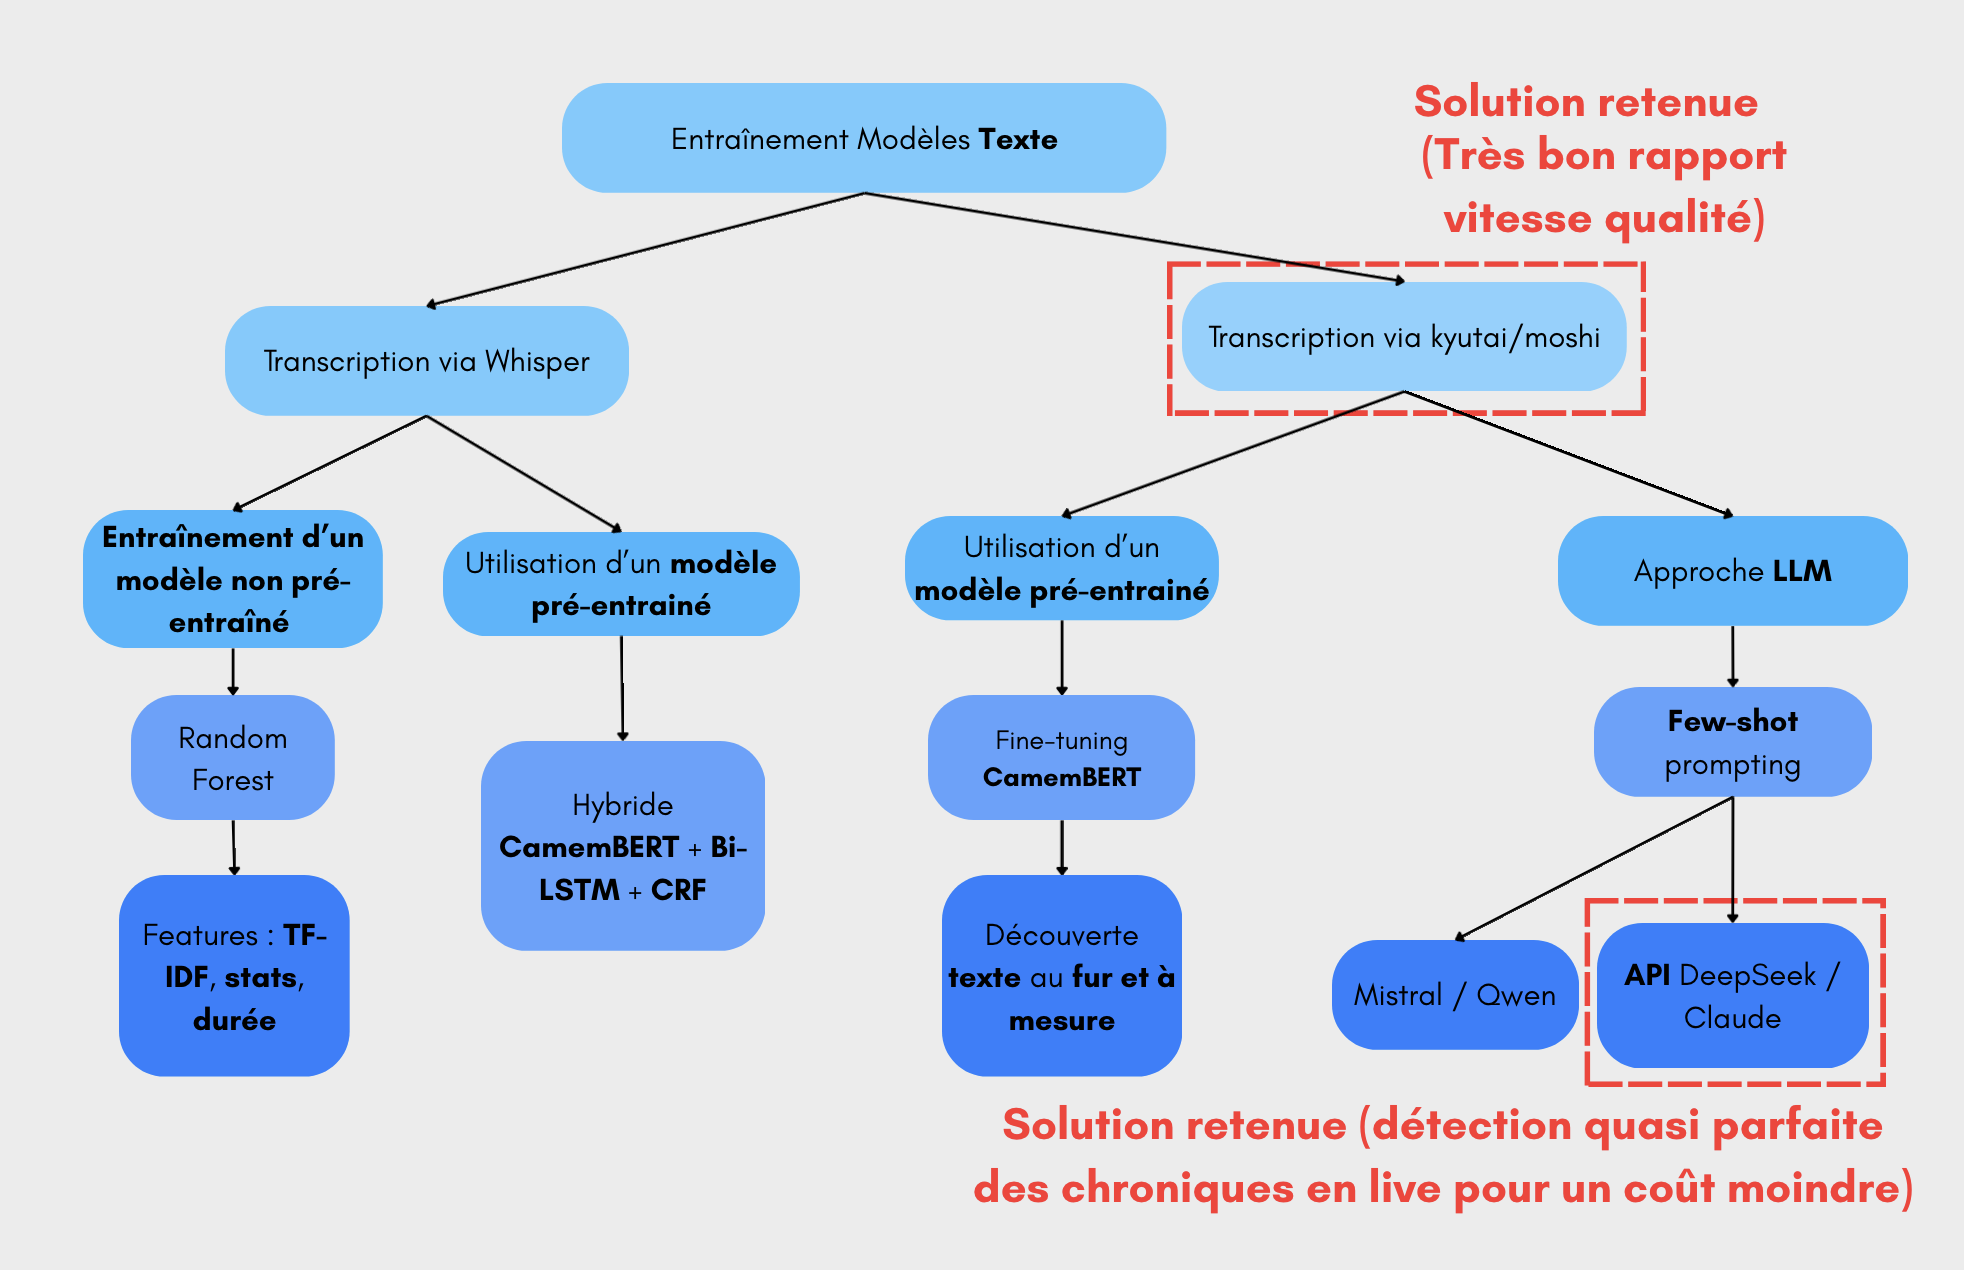
Analyse des différentes méthodes d’identification (LLM, Machine Learning, Analyse spectrale) et mise en place d’un standard d’interopérabilité JSON pour les détecteurs. Accéder à l’article
2. Recalibrage et synchronisation audio
Gestion de la latence entre le serveur de détection (Python) et le serveur d’enregistrement (Java). Utilisation des liens physiques (hard links) pour une correction rétroactive sans surcoût disque. Accéder à l’article
3. Framework d’évaluation de la qualité
Mise en place d’un système de benchmarking pour mesurer la précision des modèles de segmentation et leur capacité à respecter les contraintes du temps réel. Accéder à l’article
4. Calcul de la latence et Master Sync
Utilisation du fingerprinting audio pour calculer et compenser le décalage entre deux flux HTTP distants. Accéder à l’article
5. Transcription et Analyse Sémantique
Mise en oeuvre des pipelines STT (Speech-To-Text) avec Whisper et Kyutai. Analyse sémantique via DeepSeek pour extraire le sens des transitions radio. Accéder à l’article
6. Architecture Globale du pipeline
Vue d’ensemble de l’orchestration système. Schéma logique de circulation des données entre la capture, le moteur d’IA et l’API de distribution. Accéder à l’article
7. Capture Audio Haute Disponibilité
Focus sur le module Java/Spring Boot. Gestion de FFmpeg, threads de capture et concept de “Master Stream” pour permettre le rembobinage dynamique. Accéder à l’article
8. Validation par Tests End-to-End
Simulation d’un flux radio en direct via Docker et des pipes Unix pour valider la chaîne de traitement complète sans dépendre de la diffusion réelle. Accéder à l’article
9. Création de Datasets et Ground Truth
Méthodologie d’alignement mathématique entre les podcasts officiels et le flux live pour générer automatiquement des données d’entraînement labellisées. Accéder à l’article
10. Hub de Modèles et Datasets
Utilisation de Hugging Face pour centraliser, versionner et distribuer les modèles d’IA et les datasets du projet. Accéder à l’article
11. Monitoring avec WandB
Suivi des expériences d’entraînement et visualisation des métriques de performance en temps réel via Weights & Biases. Accéder à l’article
12. Finetuning des Modèles d’IA
Exploration des architectures (CamemBERT, AST, Wav2Vec2) et techniques de post-traitement pour affiner la précision de la détection. Accéder à l’article