GroovyMorning_RLAC
Transcription et Analyse Sémantique : La solution retenue
L’isolation d’une chronique radio dépasse la simple détection d’un signal sonore. Sur des stations telles que France Inter, les transitions sont organiques, les jingles parfois absents ou masqués par la voix de l’animateur. L’utilisation d’un pipeline de compréhension du langage naturel (NLP) permet d’atteindre une précision élevée dans GroovyMorning.
Le Pipeline de Transcription
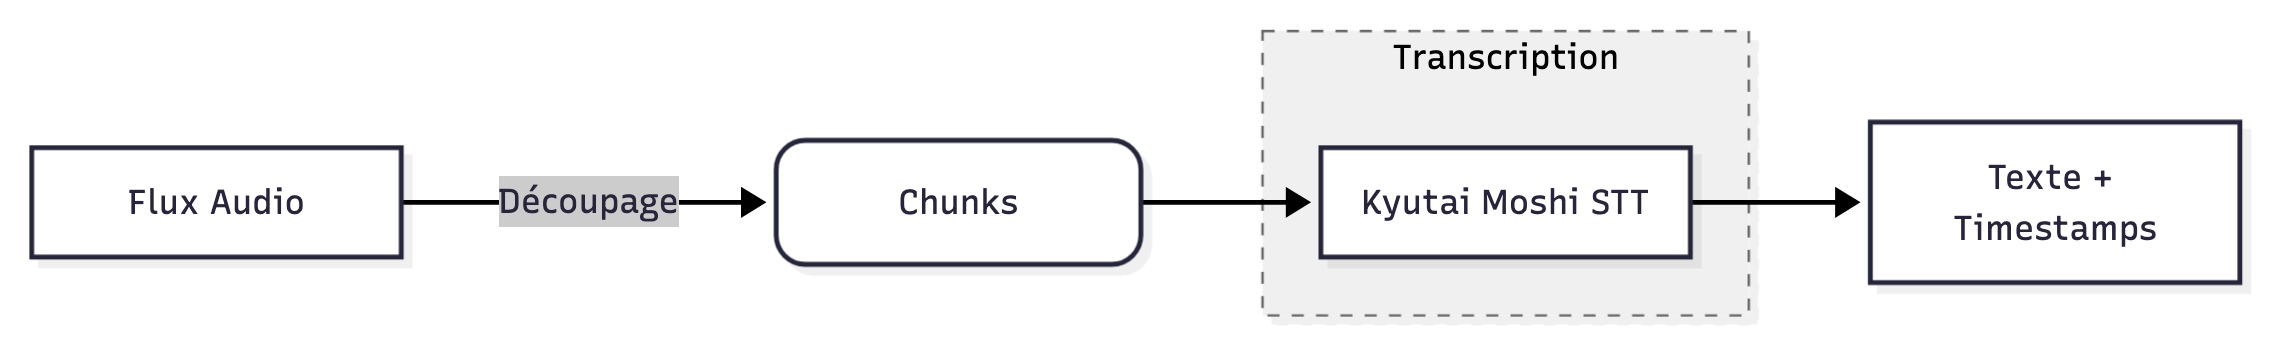
La première étape consiste en la transformation de l’audio en texte. L’approche utilisée est Kyutai (Moshi), optimisé pour une faible latence sur Mac Silicon, permettant une transcription en temps réel.
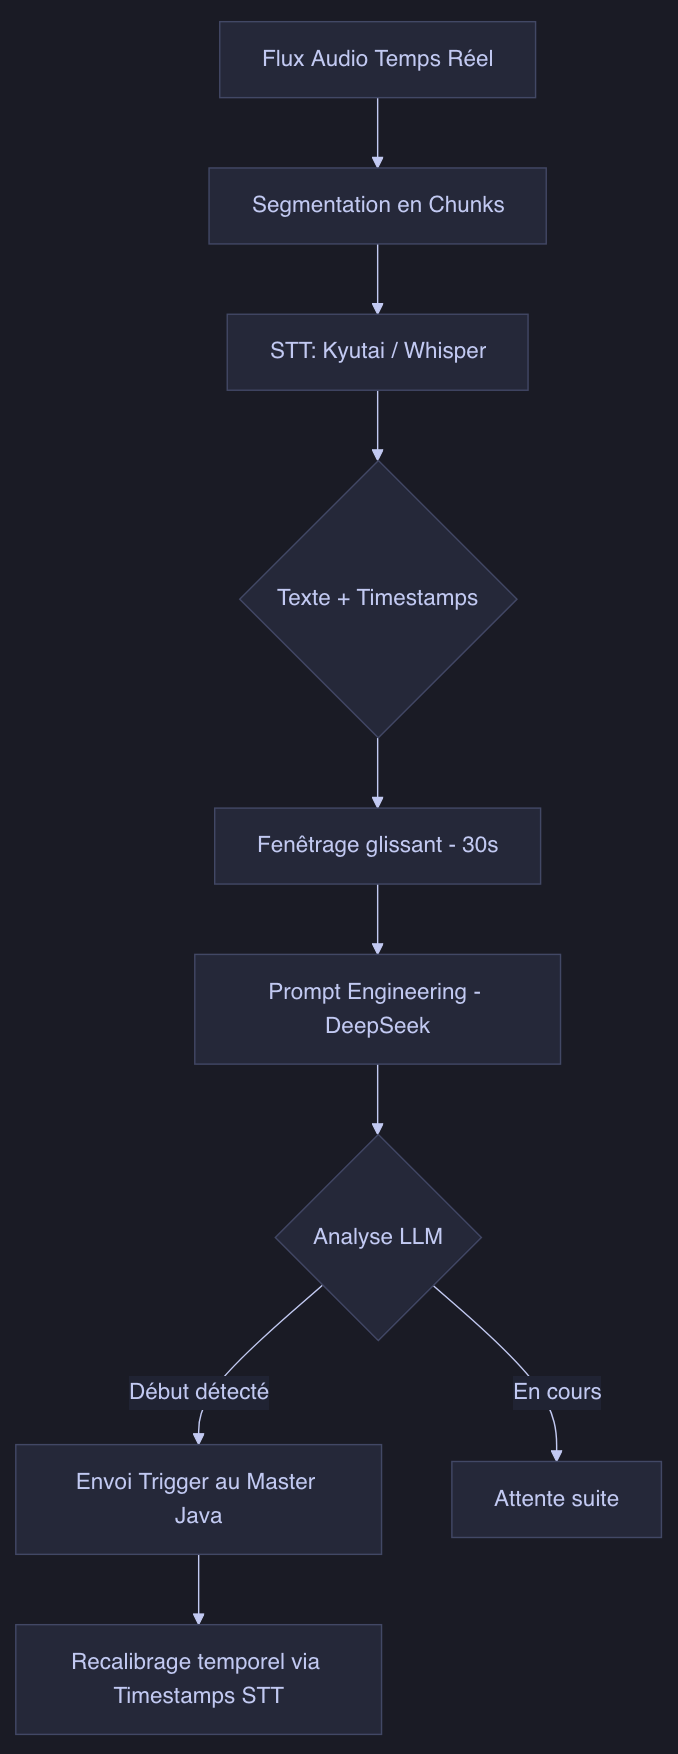
Le flux audio est découpé en chunks et transmis au modèle STT (Speech-To-Text), qui fournit le texte ainsi que les timestamps de chaque mot.
L’Analyse Sémantique avec DeepSeek
Une fois le texte obtenu, l’identification du début d’une chronique, comme “Le Billet de Géopolitique”, nécessite plus qu’un simple mot-clé. Le LLM (Large Language Model) DeepSeek est alors sollicité.
Une fenêtre de texte (correspondant aux 30 dernières secondes) est transmise au modèle avec un prompt spécifique :
“Tu es un assistant expert en radio. Analyse cette transcription et détermine si une chronique commence, se termine, ou si nous sommes en plein milieu. Identifie le nom de la chronique si possible.”
Accompagné de quelques exemples de phrases de début de chroniques ainsi que la liste complète des chroniques prévues dans l’émission.
L’IA est en mesure de comprendre le contexte :
- Animateur : “Il est 8h17, c’est l’heure de retrouver Pierre Haski…” -> DÉBUT DÉTECTÉ.
- Journaliste : “Merci Pierre, on vous retrouve demain.” -> FIN DÉTECTÉE.
Une fois que le LLM détecte un début de chronique dans le flux, il notifie le module d’enregistrement via HTTP du début de la chronique.
Recalibrage Temporel
Le temps de traitement nécessaire à l’IA (latence d’inférence) est pris en compte. Si un début de chronique est détecté à 08:15:10, le texte a pu être reçu à 08:15:15.
L’utilisation des métadonnées de transcription permet de remonter précisément à l’instant où le premier mot a été prononcé, permettant au module de capture Java de débuter l’archive à ce moment précis dans le passé du buffer.
Conclusion
La combinaison du Speech-To-Text et de l’intelligence contextuelle des LLMs permet de transformer un flux audio brut en une base de données structurée.