GroovyMorning_RLAC
Détection de chroniques radio par IA
Dans le projet, l’un des défis majeurs est l’identification automatique du début et de la fin des chroniques radio (ex: “Le 7/10 de France Inter”) au sein d’un flux audio ininterrompu.
Une approche multi-modale
Plutôt que de se reposer sur une seule méthode, un framework de recherche (R&D) a été développé pour trouver la meilleure méthode :
- Approches LLM (Large Language Models) : Utilisation de modèles comme DeepSeek ou Claude. L’audio est d’abord transcrit, puis le texte est envoyé à l’IA pour repérer les indices sémantiques de début et de fin. C’est la méthode la plus précise sémantiquement, bien qu’elle introduise une latence due au traitement.
- Machine Learning classique : Utilisation de Random Forest ou de modèles Hybrid basés sur des vecteurs de transcription. Ces modèles sont entraînés à reconnaître la signature textuelle d’une transition radio.
- Analyse Audio Native : Détection basée sur des modèles pré-entraînés qui analysent directement le spectre audio pour repérer les jingles ou les changements de locuteur.
- Transformers : Exploration de modèles d’attention pour capturer les dépendances temporelles longues dans les émissions.
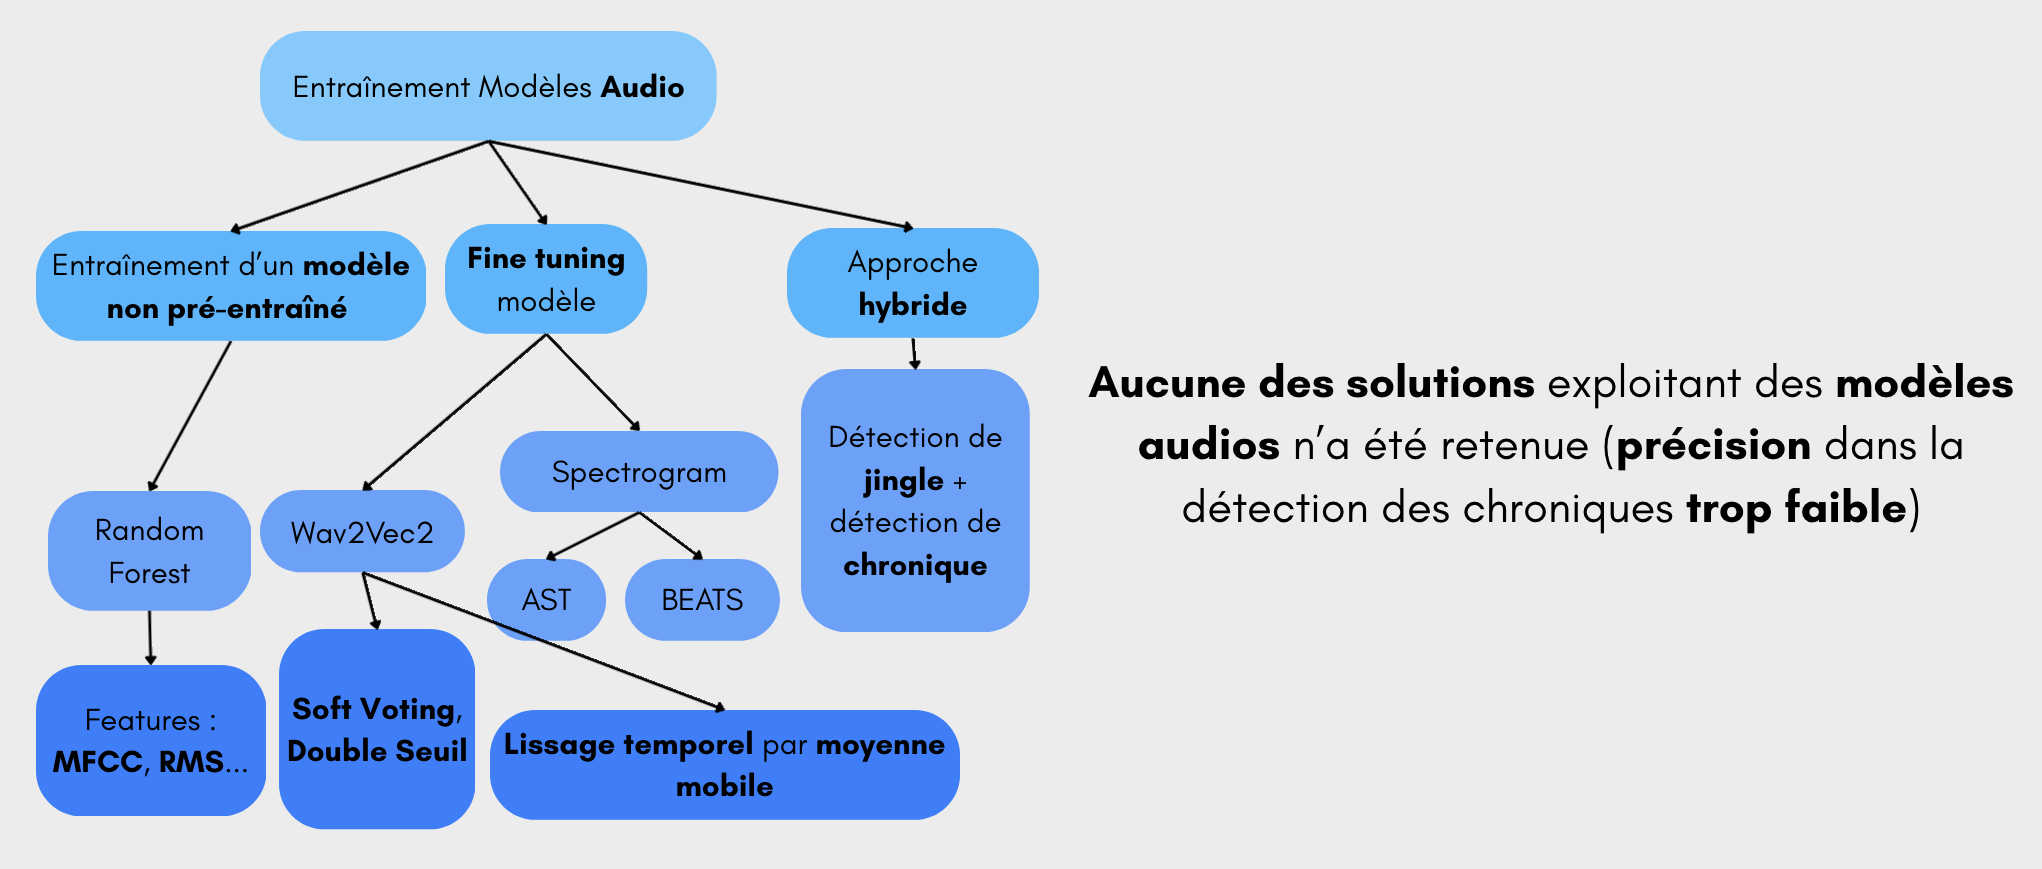
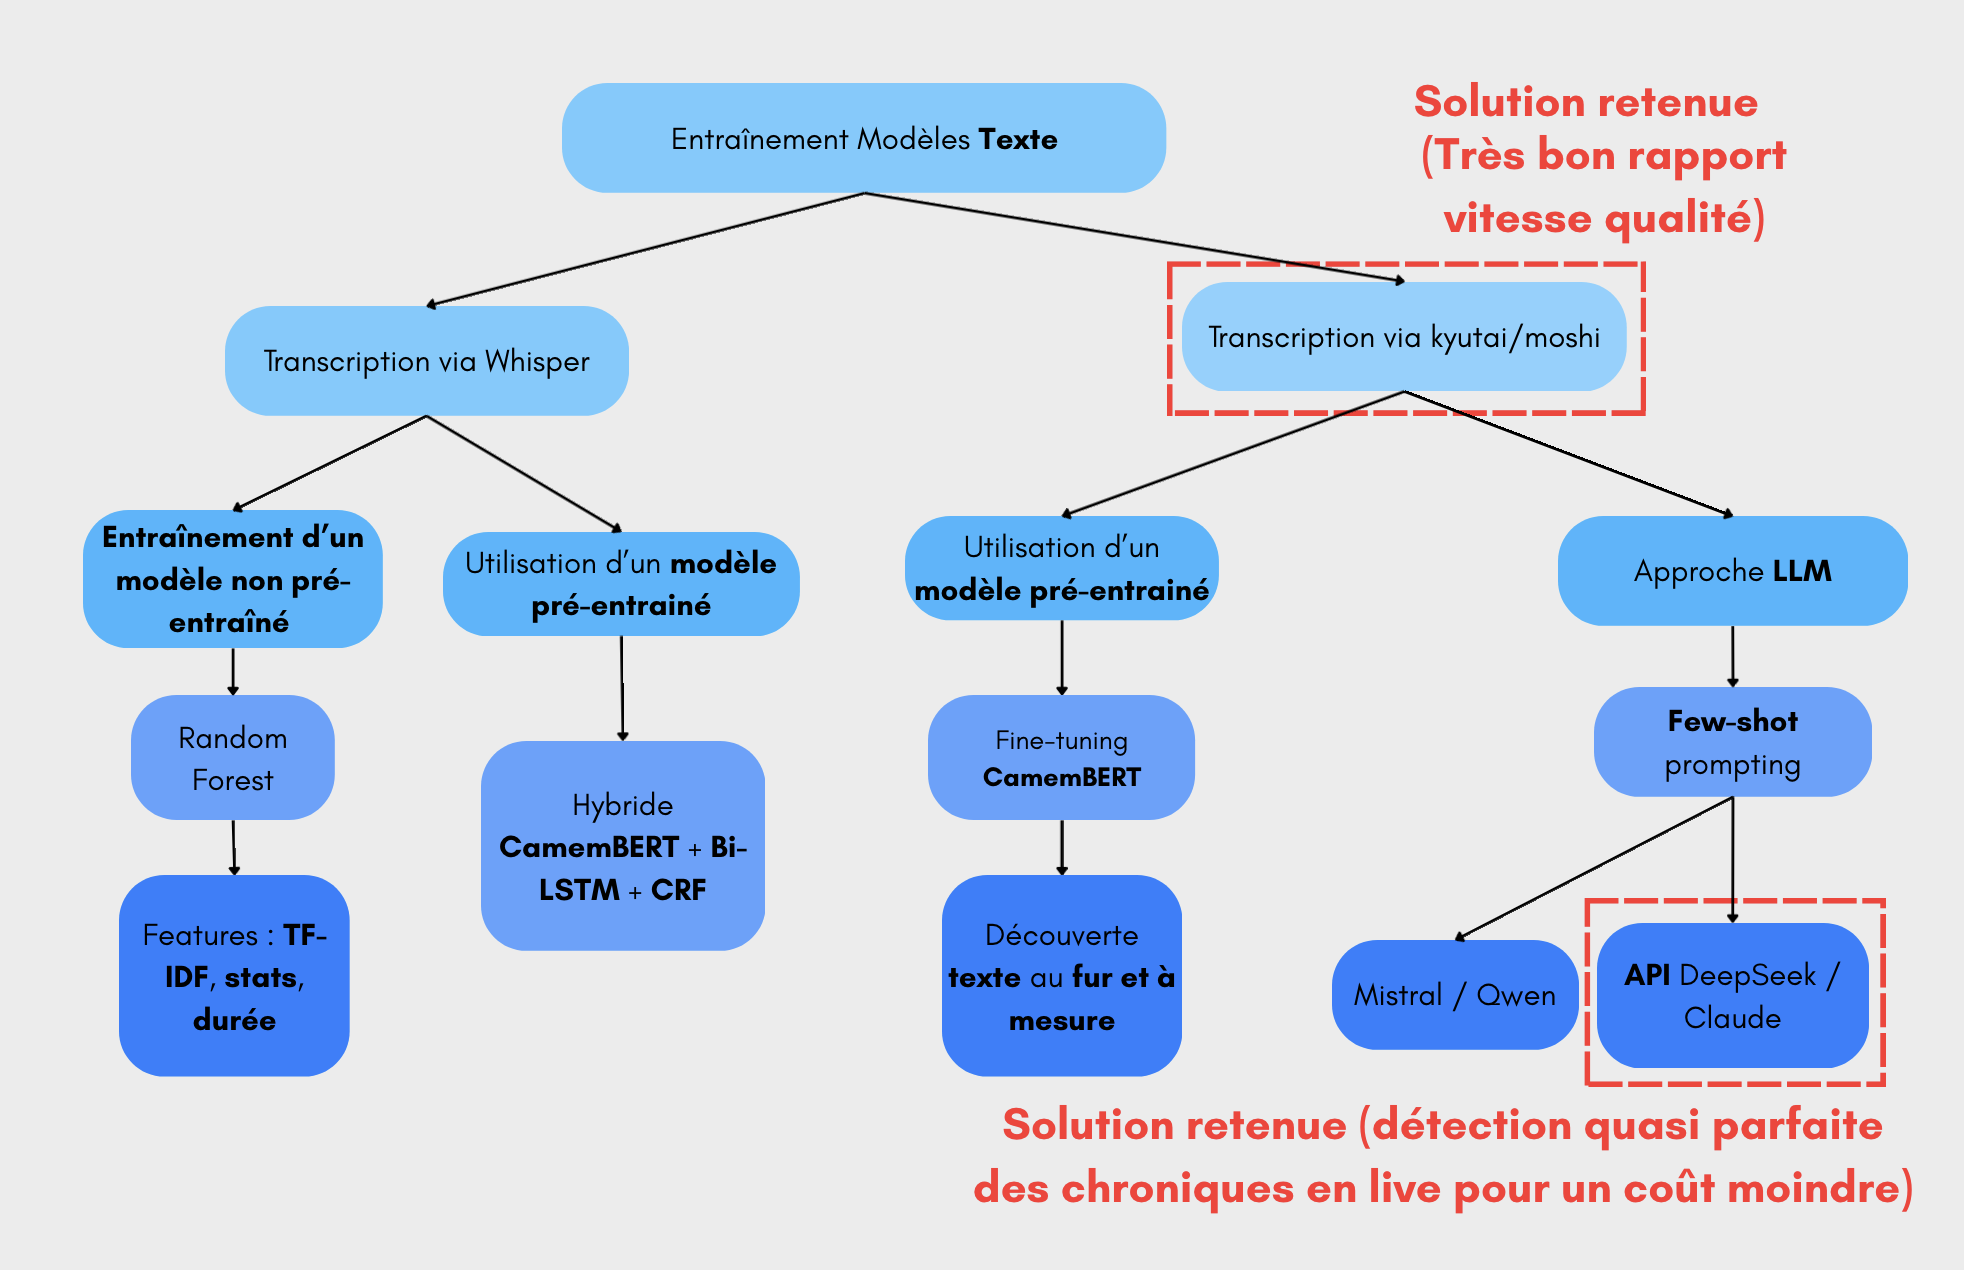
Pour voir le cheminement plus en détails :
La détection via l’audio ou la détection via le texte
Le standard d’interopérabilité
Pour faire cohabiter ces méthodes, un format de sortie JSON standardisé a été imposé. Chaque détecteur doit fournir :
[
  {
    "label": "Le journal de 7h", // nom de la chronique
    "start": 120.5,           // Début de la chronique (en secondes)
    "end": 240.0,             // Fin de la chronique (en secondes)
    "detected_at": 135.2,     // Moment précis de la confirmation par l'IA
    "confidence": 0.95        // Indice de confiance du modèle
  }
]
Ce format permet également d’évaluer ces méthodes, détaillé dans cet article.
Simulation du “Live”
Comme la détection se fait en temps réel, on nécessite un simulateur de flux. Au lieu de traiter un fichier audio statique, l’audio est découpé en buffers de quelques secondes pour simuler la réception en temps réel. Cela permet de mesurer non seulement la précision de l’IA, mais aussi sa réactivité (latence), un facteur crucial pour un service de radio à la demande “instantané”.
Cette architecture permet à GroovyMorning de rester agnostique vis-à-vis des modèles d’IA : l’intégration d’un nouveau modèle de pointe est facilitée par le respect de cette interface standard.
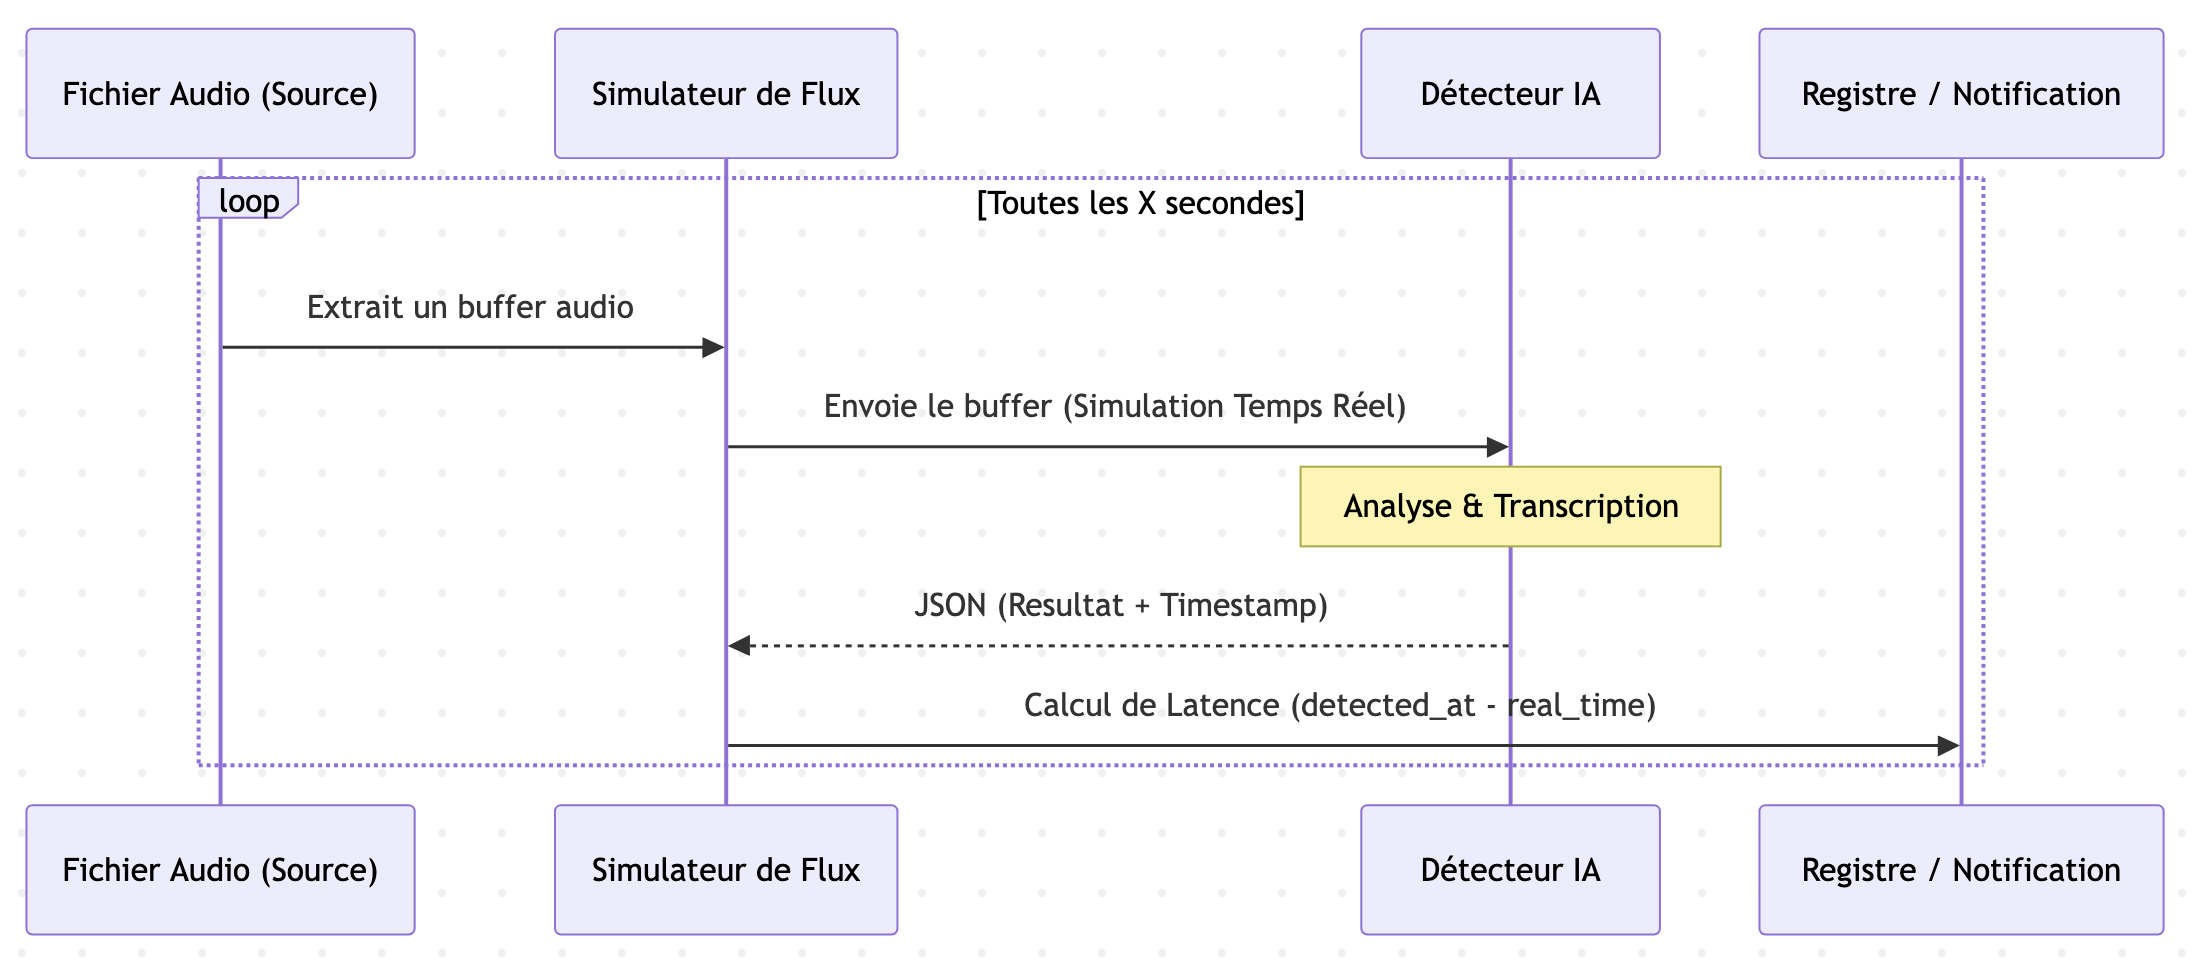
Solution retenue : transcription en live et utilisation de l’API payante de DeepSeek
Utilisation
L’API de DeepSeek (deepseek-v4-flash) est sollicitée pour détecter les phrases correspondant au début des chroniques, à partir d’une liste de chroniques à détecter (fournie dans l’ordre). Le texte est analysé au fur et à mesure, simulant un flux live.
Le few-shot prompting est utilisé pour fournir des exemples directement dans le prompt (exemples de phrases de début de chroniques).
Une fois que le LLM détecte un début de chronique dans le flux, il notifie le module d’enregistrement via HTTP du début de la chronique.
Gestion des erreurs grossières
Afin d’éviter les erreurs grossières, les chroniques sont comparées avec leur horaire théorique. Une chronique détectée dont l’horaire est déjà passé est ignorée.
La solution est plus détaillée dans cet article.