GroovyMorning_RLAC
Création du dataset
Pour réaliser le dataset de texte, il est nécessaire de transformer le flux audio en une transcription fidèle, puis de mettre cette transcription en correspondance avec les timecodes réels.
Données texte (transcription)
Évolution des modèles de transcription
La qualité de la détection textuelle dépend directement de la précision du moteur de Speech-to-Text. Plusieurs étapes ont marqué notre pipeline :
- Whisper (OpenAI) : Tests initiaux avec les modèles tiny et base, puis passage au modèle large-v3 pour une meilleure fidélité textuelle.
- Kyutai (Moshi/STT) : Adoption finale du modèle kyutai/stt-1b-en_fr pour sa performance et sa rapidité de traitement.
Téléchargement manuel et étiquetage à la main
Dans un premier temps, les émissions de radio étaient téléchargés à la main depuis les différents sites web de radio et les chroniques étaient détectés à la main de manière humaine, dans un fichier texte indiquant le nom de la chronique ainsi que le timecode de début et le timecode de fin.
Téléchargement manuel, étiquetage via LLM et vérification humaine
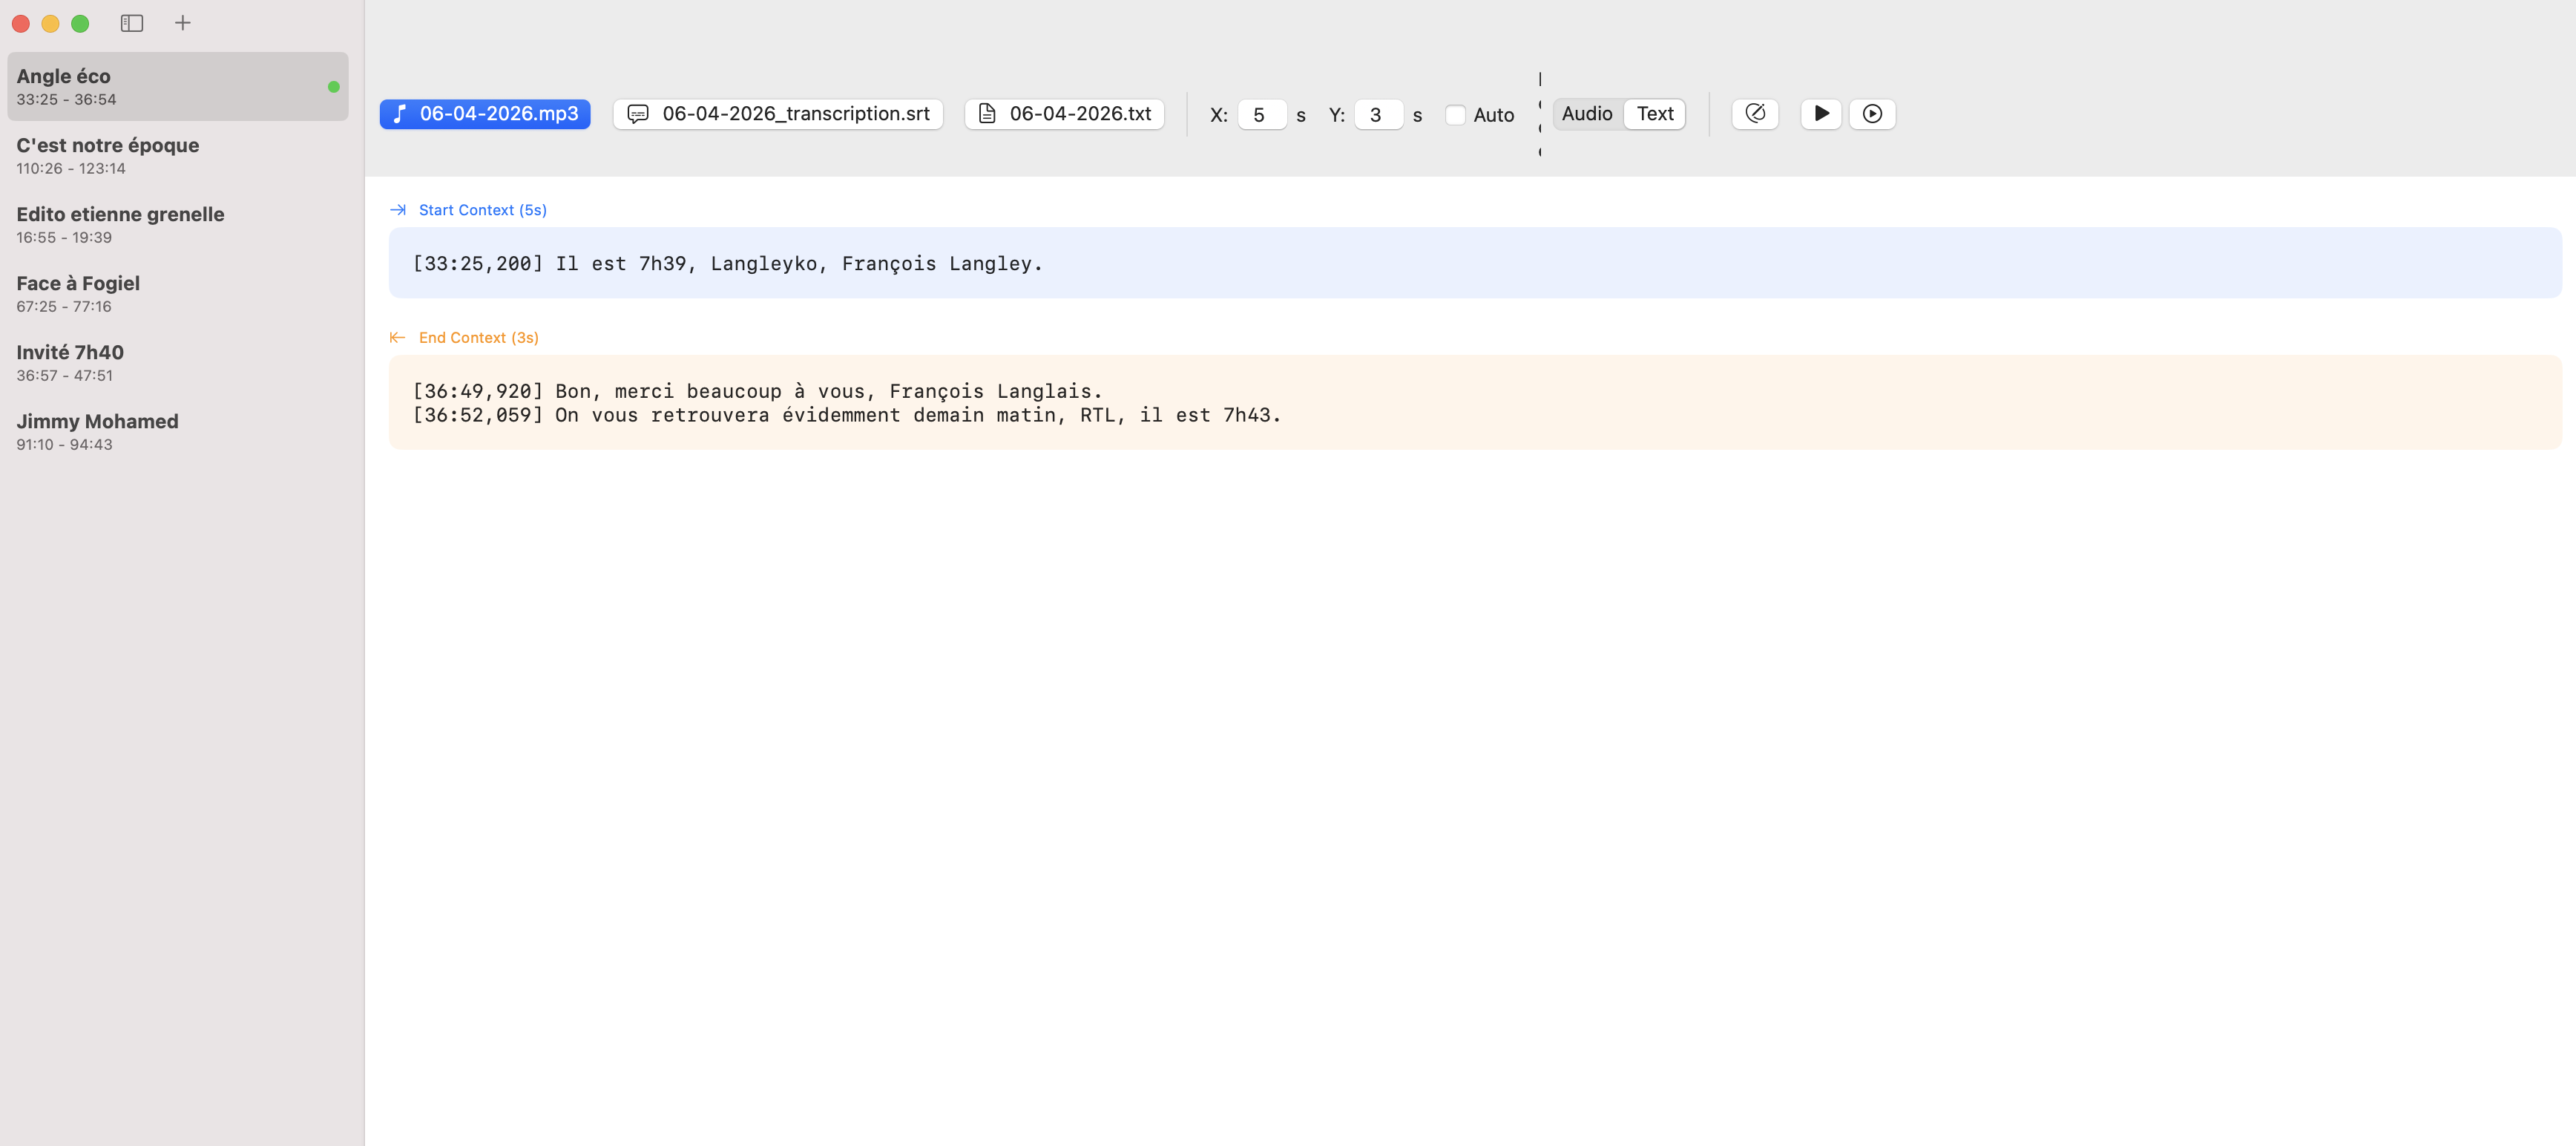
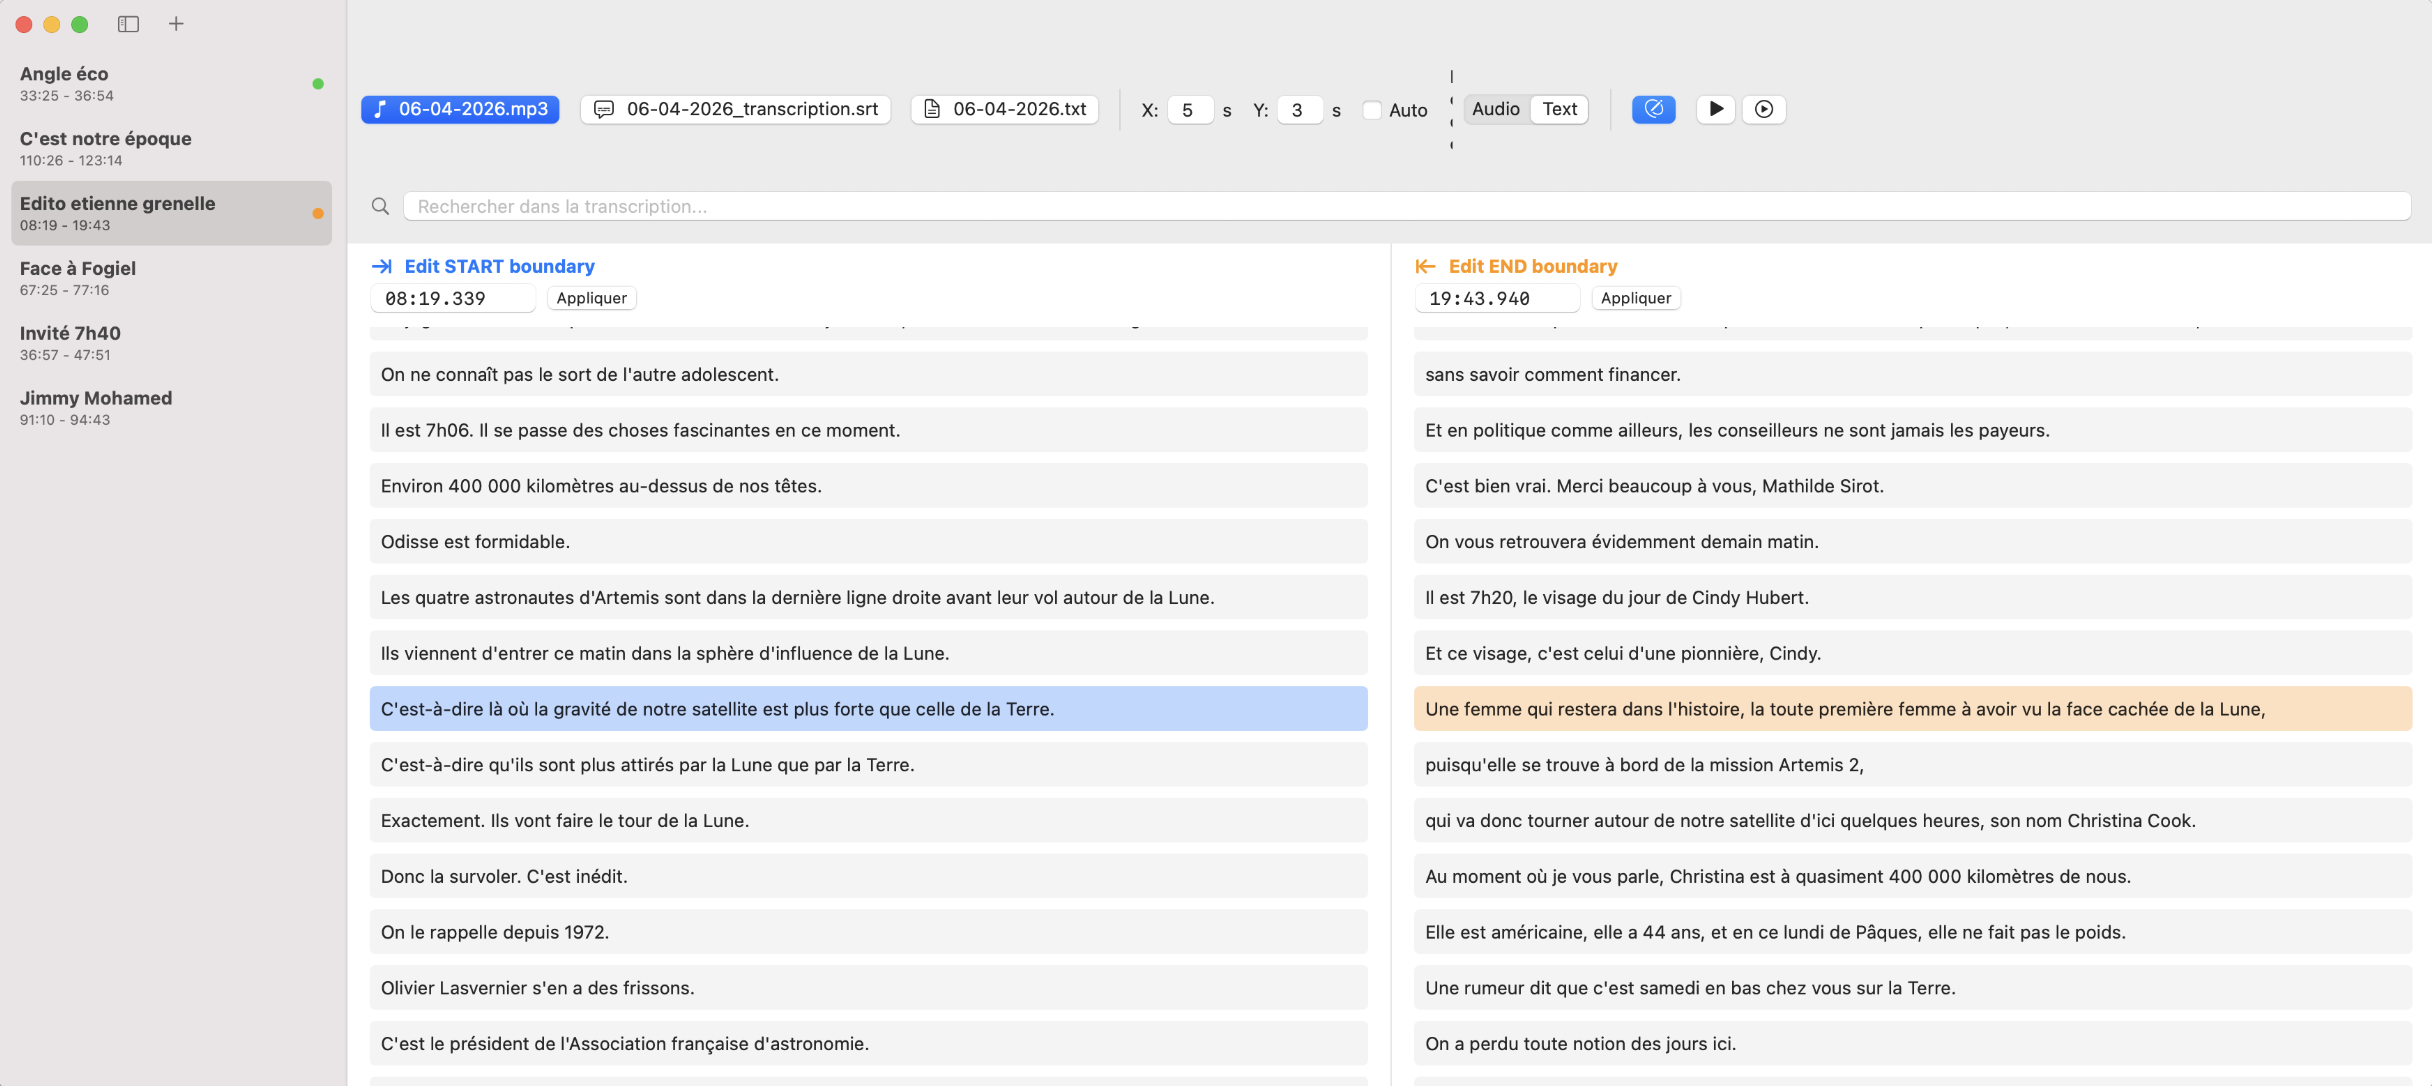
La détection des chroniques entièrement humaine a ensuite été remplacée par une détection via un LLM (gemini en cli) qui créait les fichiers texte avec les timecodes des chroniques. Une vérification humaine était ensuite appliquée via une interface Swift macOS.
Visualisation de la phrase du début de la chronique et celle de fin
Édition manuelle de la phrase de début et de fin
Téléchargement et détection automatique
La technique actuellement utilisée est 100% automatique et ne nécessite aucune intervention humaine.
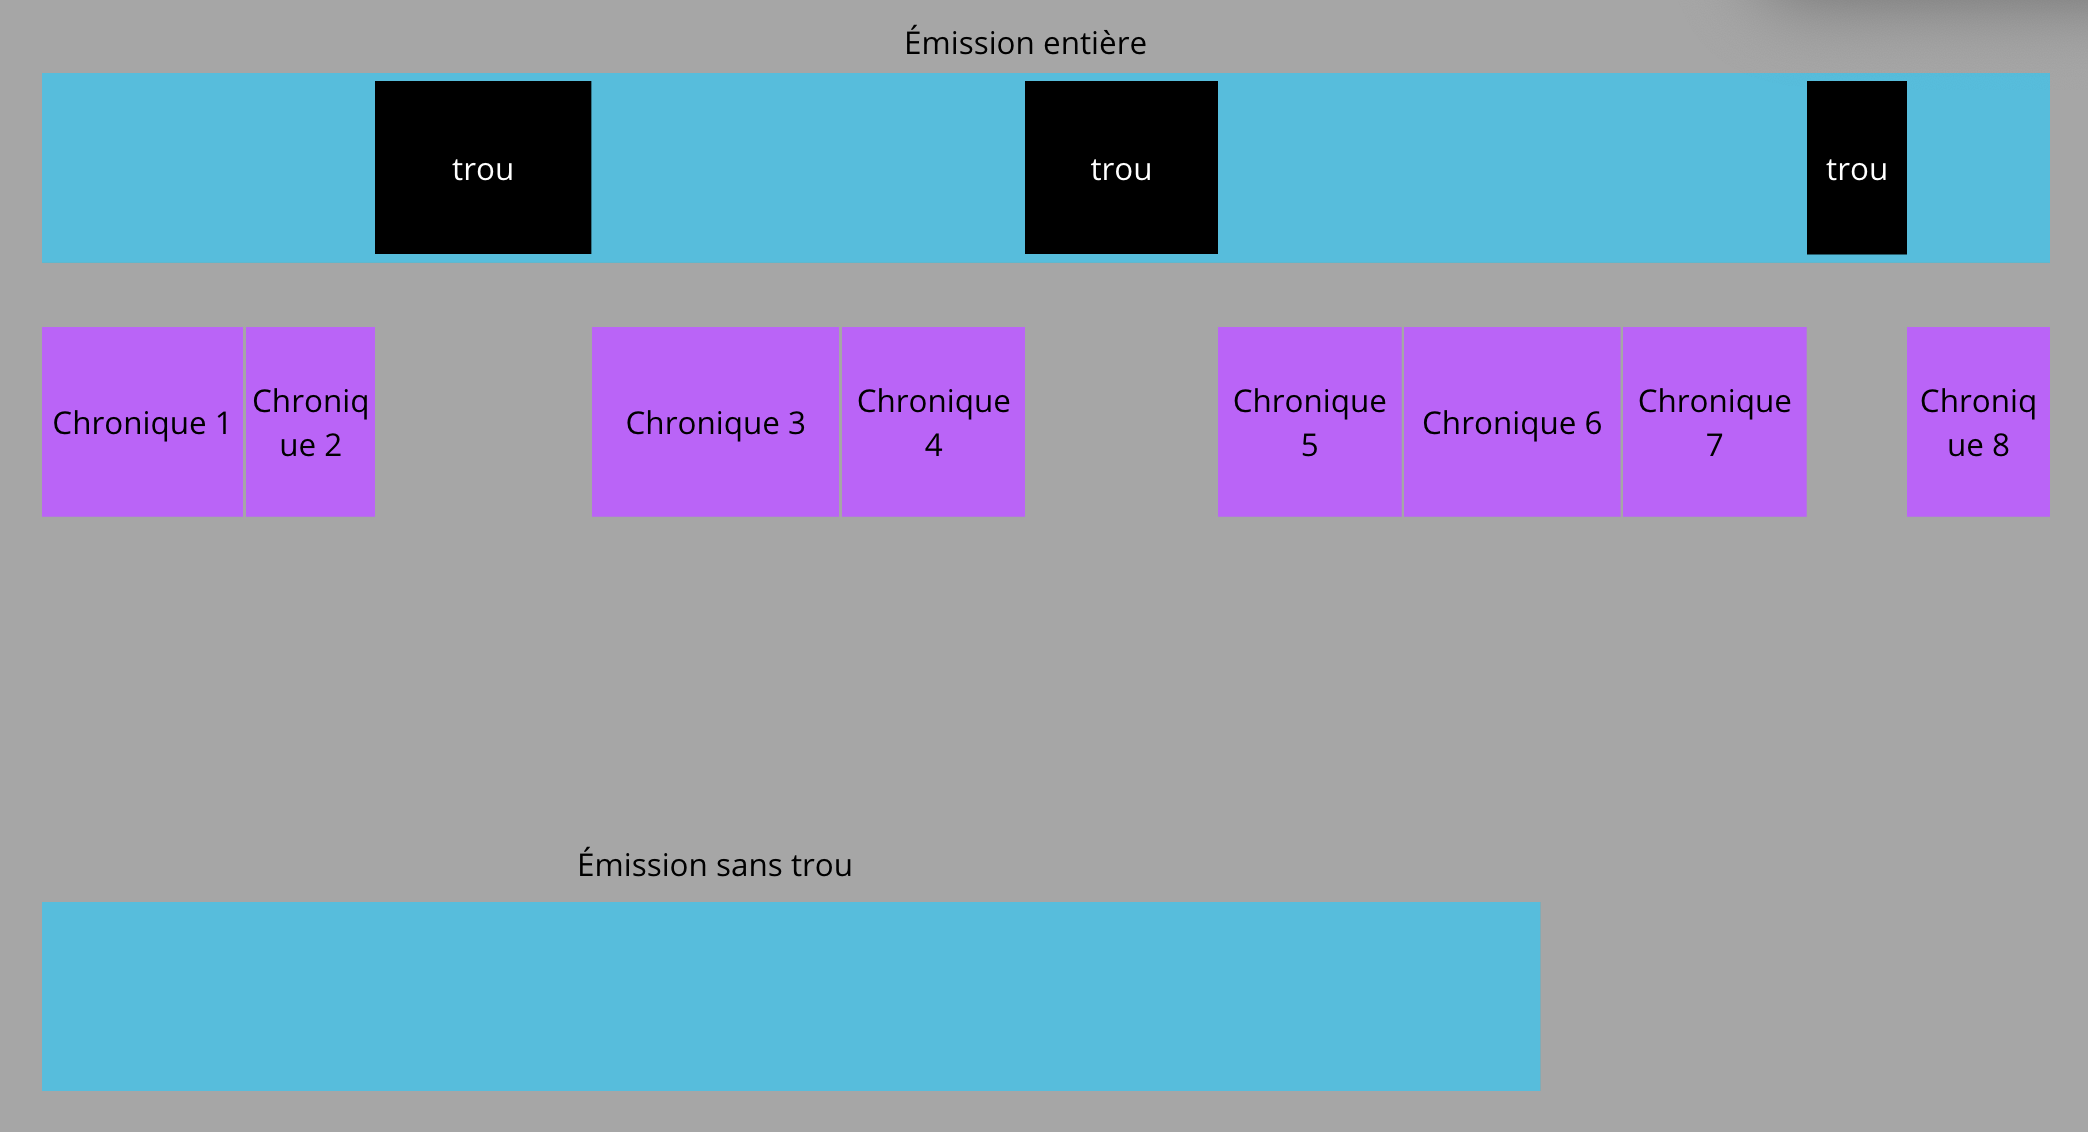
- Téléchargement des émissions : Le téléchargement des émissions et des chroniques la composant est entièrement fait automatiquement par un programme Python. Cependant, le programme n’arrive pas à récupérer certaines chroniques, donc l’intégralité des chroniques n’est pas téléchargée.
- Détection des chroniques : Un second programme analyse l’audio complet et retrouve les chroniques dans cet audio pour en déduire la position des chroniques dans l’audio et créer le fichier texte qui renseigne la position des chroniques dans l’audio.
- Ajustement du fichier texte et audio : Comme certaines chroniques manquent, il ne faut pas les étiquetter comme ‘non chronique’. Un troisième programme déduit la liste des chroniques manquantes à partir de la liste théorique des chroniques présentes dans l’émission, enlève les parties avec les chroniques manquantes de l’audio et ajuste le fichier texte en prenant en compte le nouvel audio et les chroniques manquantes.
- Transcription complète: L’émission complète est entièrement transcrite via kyutai.
Extraction des premières phrases
On a ensuite créé un second dataset contenant les phrases de début de chroniques.
On extrait les 10 premières secondes de chaque chronique qu’on transcrit, pour extraire la première phrase de la chronique (via analyse de la ponctuation).
Cette première phrase marquant le début de la chronique, elle constitue un dataset de phrases de début de chronique.